최소한으로 울리는 알림 만들기: 비정상 병원 알림
병원은 진료 중인데 똑닥 앱에서는 접수가 되지 않습니다. 병원 PC와 연결이 끊어졌지만 누구도 상황을 인지하지 못합니다. 유저가 고객센터에 문의한 뒤에야 대응이 시작되기도 합니다. 접수가 비정상적으로 멈춘 상황을 먼저 발견하고 대응할 수 있도록 비정상 병원을 감지하는 알림을 만들었습니다.
접수가 닫혀 있는 병원을 찾는 것만으로는 충분하지 않았습니다. 휴게시간이나 휴진처럼 정상적으로 접수를 중단한 병원은 제외해야 했고, 여러 서버가 같은 병원을 동시에 감지하더라도 알림은 한 번만 발송되어야 했습니다. 무엇을 비정상으로 볼지, 언제 알림을 보낼지, 중복을 어떻게 막을지, 필요한 순간에만 알림이 울리도록 기준을 정한 과정을 공유합니다.
비정상 병원 판정 구조 (MongoDB, Kafka)
판정 기준
1차 판정에서 접수에 필요한 설정이 갖춰졌는지 확인하고 이를 통과한 병원에 한해 2차 판정이 실시간 접수 가능 여부를 봅니다.
| 단계 | 확인하는 내용 | 실행 시점 |
|---|---|---|
| 1차 | 접수 설정이 갖춰져 있는가 — 활성 진료실, 접수 설정 | 하루 한 번 전체 확인 + 변경 감지 |
| 2차 | 지금 접수를 받을 수 있는가 — 접수 가능한 진료실, 에이전트 연결 | N분 주기 배치 + 변경 감지 |
2차 판정은 결과만 남기지 않습니다. 접수 가능한 진료실의 유무와 에이전트 연결 상태가 근거로 따로 기록되어 점심시간이나 휴진으로 접수를 닫은 병원과 에이전트가 끊긴 병원을 나눠 볼 수 있습니다. 이번 알림은 끊김만 다루므로 두 가지 근거 중 연결 상태를 봅니다. 에이전트와 일정 시간 통신이 없으면 상태가 "끊김"으로 바뀌고, 통신이 다시 이어지면 "연결됨"으로 돌아옵니다.
판정 요청 경로
배치는 스케줄에 따라, 변경 감지는 데이터 변경 이벤트가 생길 때마다 판정 요청을 발행합니다. 휴게시간 시작과 접수 종료는 시간이 지나면 저절로 바뀌는 상태라 DB에 변경이 일어나지 않습니다. 그래서 주기 배치가 1차 통과 병원들을 대상으로 N분마다 다시 판정을 요청합니다. 요청은 모두 하나의 Kafka 토픽에 모이고, 컨슈머가 출처 값으로 구분해 판정한 뒤 결과를 Redis 목록 갱신이나 검색 색인 같은 후처리로 넘깁니다.
| 출처 | 시점 | 대상 | Kafka key |
|---|---|---|---|
| 일 배치 | 매일 새벽 | DB에서 집계한 접수 사용 병원 전체 | 없음 |
| 주기 배치 | N분마다 | Redis에 저장된 1차 통과 병원을 여러 곳씩 묶어 요청 | 없음 |
| 변경 감지 | 데이터가 바뀔 때 | MongoDB Change Stream(CDC)으로 변경을 감지한 병원 1곳 | 병원 ID |
요청 출처마다 메시지 key가 다른데, Kafka는 이 key로 파티션을 정합니다. 변경 감지는 병원 ID가 key라 같은 병원의 요청이 한 파티션에 차례로 쌓입니다. 주기 배치는 여러 병원을 한 메시지에 묶어 key가 없으므로, 회차마다 다른 파티션과 컨슈머로 흩어질 수 있고 순서도 보장되지 않습니다. 다만 메시지에는 다시 판정할 병원 목록만 담기고 컨슈머가 처리 시점에 DB에서 최신 상태를 읽으므로, 순서가 바뀌어도 판정 결과는 같습니다.
알림 발송 설계 (Redis, Slack)
알림 구조
초기 설계는 알림을 판정 흐름과 분리해 별도 크론에 맡기는 방식이었습니다. 짧은 주기로 Redis에 쌓인 1차·2차 판정 결과를 조합해 접수가 안 되는 병원을 추리는 크론과 매일 밤 복구되지 않은 건을 일괄 정리하는 크론입니다. 그러나 팀 내 설계 리뷰에서 새 크론 대신 이미 돌고 있는 판정 흐름을 재활용하자는 의견이 나왔습니다. 판정 컨슈머가 계산한 병원 상태를 크론이 Redis에서 다시 조합하면 같은 계산을 두 번 하는 셈입니다. 판단 기준도 양쪽에 생겨 한쪽만 고치면 운영 화면과 알림이 어긋날 수 있습니다. 크론이 제때 돌았는지, 실패하지 않았는지 지켜봐야 해서 감시 대상도 늘어납니다.
그래서 알림은 판정 컨슈머의 후처리 단계로 옮겼습니다. 후처리는 판정 결과를 그대로 넘겨받아 조건을 확인하므로 Redis 목록을 다시 조합하지 않습니다. 판단 기준도 판정 로직 한 곳으로 일원화되어 운영 화면과 알림이 같은 결과를 봅니다. 미복구 건을 정리하던 크론 대신 감지·발송 기록을 담은 Redis 키에 TTL을 걸어 자정에 만료되게 했습니다. 알림을 위해 따로 크론을 만들지 않고 판정 흐름 하나로 처리하도록 구조를 단순화했습니다.
발송 대상
접수 설정은 갖춰 두고 앱 접수는 쓰지 않는 병원도 있습니다. 이런 병원까지 알림에 넣으면 조치가 필요한 실사용 병원들이 묻히게 됩니다. 그래서 대상은 최근 진료완료 실적이 있는 병원으로 좁히고 기존 지표와 집계 기준을 맞춰 결과를 대조했습니다.
알림마다 실적을 집계하면 환자 접수를 처리하는 DB에 부하가 갑니다. 그래서 일 배치가 실사용 목록을 Redis Set에 만들어 두고 컨슈머는 SISMEMBER로 포함 여부만 확인합니다.
Redis 초기화 등으로 목록이 빌 수 있는데 이때 모든 병원으로 알림을 열면 미사용 병원까지 쏟아집니다. 그래서 목록이 비어 있을 때는 병원별 알림을 멈추고 이 때문에 놓칠 수 있는 장애는 아래처럼 보완했습니다.
- 목록이 비면
[감지 중단]경고를 RedisNX(키가 없을 때만 저장)로 하루 한 번만 보냅니다. - 새 집계 결과가 없으면 기존 목록을 계속 씁니다. 목록에 만료 시간이 없어 배치가 하루 실패해도 이전 목록으로 동작합니다.
- 임시 키를 채운 뒤
RENAME(임시 키를 기존 키 이름으로 바꿔 한 번에 덮어씀)으로 교체해 갱신 중에도 목록이 비지 않게 합니다.
실사용 목록에 든 병원도 휴게시간이나 휴진일에는 실제 접수 가능 여부를 판별하는 2차 판정에 실패하므로 실패 여부만 보고 알림을 보낼 수는 없습니다. 그래서 2차 판정에 실패한 병원 중 접수 가능한 진료실은 있는데 에이전트 연결이 끊긴 병원만 발송 대상으로 선별했습니다.
| 상황 | 2차 판정 | 접수 가능한 진료실 | 알림 |
|---|---|---|---|
| 정상 접수 중 | 통과 | 있음 | 보내지 않음 |
| 휴게시간·휴진 등 접수 시간 외 | 실패 | 없음 | 보내지 않음 |
| 에이전트 연결 끊김 | 실패 | 있음 | 보냄 |
발송 시점
연결이 끊겼다고 바로 알림을 발송하지 않습니다. 잠깐 끊긴 연결은 담당자가 병원에 연락하기도 전에 복구될 수 있기 때문입니다. 초기 설계에서는 두 번 연속으로 끊겨 있으면 알림을 보내기로 했습니다. 하지만 끊김이 DB에 기록되는 순간 변경 감지(CDC)가 보낸 판정 요청이 첫 관측을 차지하고 곧이은 주기 배치가 두 번째 관측이 되어 끊긴 지 1~2분 만에 알림이 발송됐습니다. 그래서 횟수 대신 끊김 경과 시간으로 판단하도록 바꿨습니다.
끊김 경과 시간을 재려면 시작점과 현재 시점이 필요합니다. 다만 비정상 판정 메시지는 회차마다 다른 파티션과 컨슈머로 흩어질 수 있고 파티션마다 지연도 다릅니다. 그래서 첫 관측 시각을 HSETNX로 저장해 두고 기준 시간이 지나면 알림을 보냅니다. HSETNX는 최초 저장된 값을 덮어쓰지 않아 여러 컨슈머가 나눠 맡아도 기준이 같습니다. 현재 시점은 컨슈머가 메시지를 처리한 시각이 아니라 메시지가 발행된 시각으로 잡습니다. 발행 시각은 파티션 처리가 지연되거나, 오프셋 커밋 전에 컨슈머가 중단돼 메시지가 다시 전달되어도 바뀌지 않습니다. 그래서 Kafka 전달 과정으로 인한 시간 왜곡 없이 일관된 계산을 보장할 수 있습니다.
중복 발송 방지
조건을 만족한 병원을 여러 컨슈머 파드가 동시에 처리하면 같은 알림이 여러 번 나갈 수 있습니다. 중복 발송을 막기 위해 Redis SET NX로 발송 키를 원자적으로 선점한 파드만 알림을 발송하게 했습니다. 그런데 선점한 파드가 발송 도중 멈추면 키만 남아 다음 발송까지 막히게 됩니다. 그래서 선점을 언제 어떻게 풀지 정해야 했습니다. 발송이 끝나면 코드가 키를 지우는 직접 해제 방식과 일정 시간(TTL)이 지나면 키가 저절로 사라지는 자동 만료 방식을 비교했습니다.
| 상황 | 직접 해제 | 자동 만료 (lease) |
|---|---|---|
| 정상 발송 | 발송이 끝나면 코드가 키를 지운다 | TTL이 지나면 키가 저절로 사라진다 |
| 발송 중 파드가 멈춤 | 키가 남아 다음 발송이 계속 막힌다 | TTL이 지나면 풀려 다음 회차에 다시 시도한다 |
| 발송이 TTL보다 오래 걸림 | 발송이 끝날 때까지 선점이 유지된다 | 키가 먼저 풀려 다른 파드가 중복 발송할 수 있다 |
비정상 알림에선 프로세스가 멈춰도 선점이 스스로 풀리는 자동 만료를 택했습니다. TTL은 슬랙 호출의 타임아웃과 재시도를 합친 시간보다 길면서 배치 주기보다 짧게 잡아 발송 중에는 선점을 유지하고 실패하면 다음 회차 전에 풀리게 했습니다.
발송에 성공하면 선점 키 만료를 자정까지 늘려 발송 플래그로 씁니다. 복구되면 해당 키를 지우는데, 복구 전에 끊김 판정이 들어오더라도 이 키가 남아 있어 중복 발송되지 않습니다. 만료 시간 연장에는 Redis XX(키가 이미 있을 때만 저장) 조건을 붙여 발송 중 복구로 지워진 키가 되살아나지 않도록 방지했습니다.
요약 알림
병원별 중복 알림은 막았지만 여러 병원이 한 번에 끊기면 채널이 알림에 뒤덮일 수 있습니다. 기준치 이상의 동시다발적인 끊김은 장애로 간주하고 요약 알림 한 건으로 묶는 것이 필요했습니다. 문제는 여러 컨슈머에서 카운트를 어떻게 세느냐였습니다. 먼저 모든 컨슈머가 Redis 키 하나에 누적하는 방식을 검토했습니다. 그러려면 회차를 묶을 식별자가 필요한데 메시지에는 없었습니다. 식별자가 있더라도 기준을 넘기 전에 처리된 메시지는 이미 개별 알림을 보낸 뒤라 요약으로 묶을 수 없었습니다. 그래서 누적 방식 대신 개별 컨슈머가 하나의 메시지 안에서 집계하는 방식을 채택했습니다.
판정 배치가 병원 100개씩 묶어 발행한 메시지 안에서 새로 끊긴 병원을 집계합니다. 기준치를 넘으면 Redis SET NX로 요약 발송 키를 선점한 컨슈머 하나만 요약 알림을 보냅니다. 키가 살아 있는 동안은 다른 메시지도 개별 발생 알림을 중단합니다. 메시지 안에서만 세므로 한 회차의 끊긴 병원이 여러 메시지에 나뉘면 합산이 기준을 넘어도 요약 알림이 발송되지 않는 한계가 있습니다. 그러나 각 컨슈머가 다른 컨슈머를 기다리지 않고 판단하므로 동시 장애를 지연 없이 알릴 수 있습니다.
복구 알림
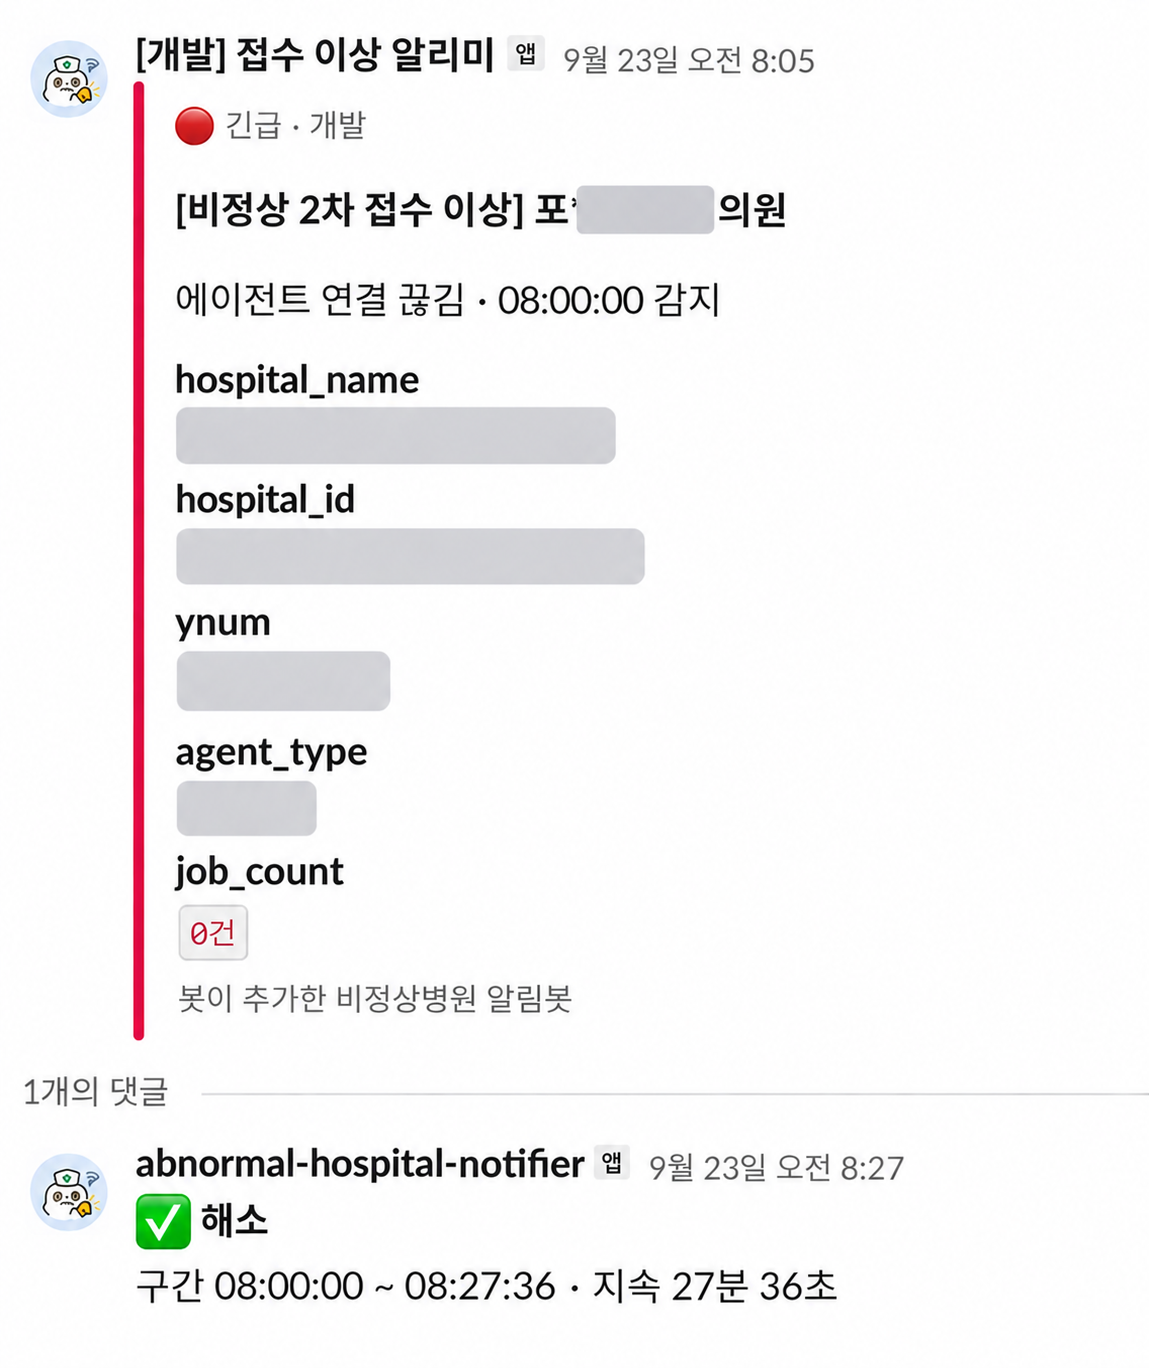
에이전트 연결이 복구되면 해당 병원의 끊김 알림 스레드에 복구 알림을 남깁니다. 끊김부터 복구까지 한곳에 모여 어떤 병원의 이슈가 해소됐는지 바로 확인할 수 있습니다. 답글을 달려면 앞서 보낸 슬랙 메시지의 식별자 ts가 필요한데 슬랙에서 기본적으로 제공하는 Incoming Webhook은 ts를 돌려주지 않습니다. 대신 사내 알림 서버를 활용해 봇 토큰으로 받은 ts를 groupKey별로 기억했다가 복구 알림을 그 스레드에 답글로 붙입니다.
복구 알림에는 끊김을 처음 관측한 시각부터 복구로 판정한 시각까지의 지속 시간을 담습니다. 이후 최초 관측 시각과 발송 키를 Redis 트랜잭션으로 함께 지워 다음 끊김을 새로 추적할 수 있도록 했습니다. 접수 중단을 감지해 필요한 경우에만 알리고 복구 여부까지 전달한 뒤 해당 끊김에 대한 추적을 마칩니다.
마치며
알림의 기준을 정하는 일은 어떤 상황에 대응해야 하는지 정하는 일이기도 했습니다. 실제 접수를 받는 병원인지, 끊김이 충분히 이어졌는지, 이미 알린 상황인지를 함께 확인해야 했습니다. 잠깐의 끊김은 기다리고 같은 문제는 반복해서 알리지 않도록 하면서 담당자가 확인해야 할 알림의 범위를 좁혔습니다.
구현 과정에서는 기존 시스템이 이미 알고 있는 정보를 활용하는 것이 도움이 됐습니다. 판정 결과를 그대로 받아 판단 기준이 갈라지는 것을 막았고 메시지의 처리 지연이나 재전달이 알림 시점에 영향을 주지 않도록 했습니다. 발송 조건을 만족하는지만큼 그 조건을 언제, 어떤 정보로 판단하는지도 중요했습니다.
이제 유저 문의가 들어오기 전에 접수 중단을 확인하고 미리 조치할 수 있게 됐습니다. 앞으로는 알림 이후의 조치와 복구 결과를 살펴보며 대응이 필요한 상황을 더 정확하게 알리도록 개선해 나가려 합니다.